Wenn die Grundgesamtheit keine Grenze mehr hat - KI in den Sozialwissenschaften
KI-Digital
Extremistische Online-Diskurse wachsen schneller, als Menschen sie sichten können. Wie KI diese Menge prüfbar macht, ohne die Entscheidung zu übernehmen.
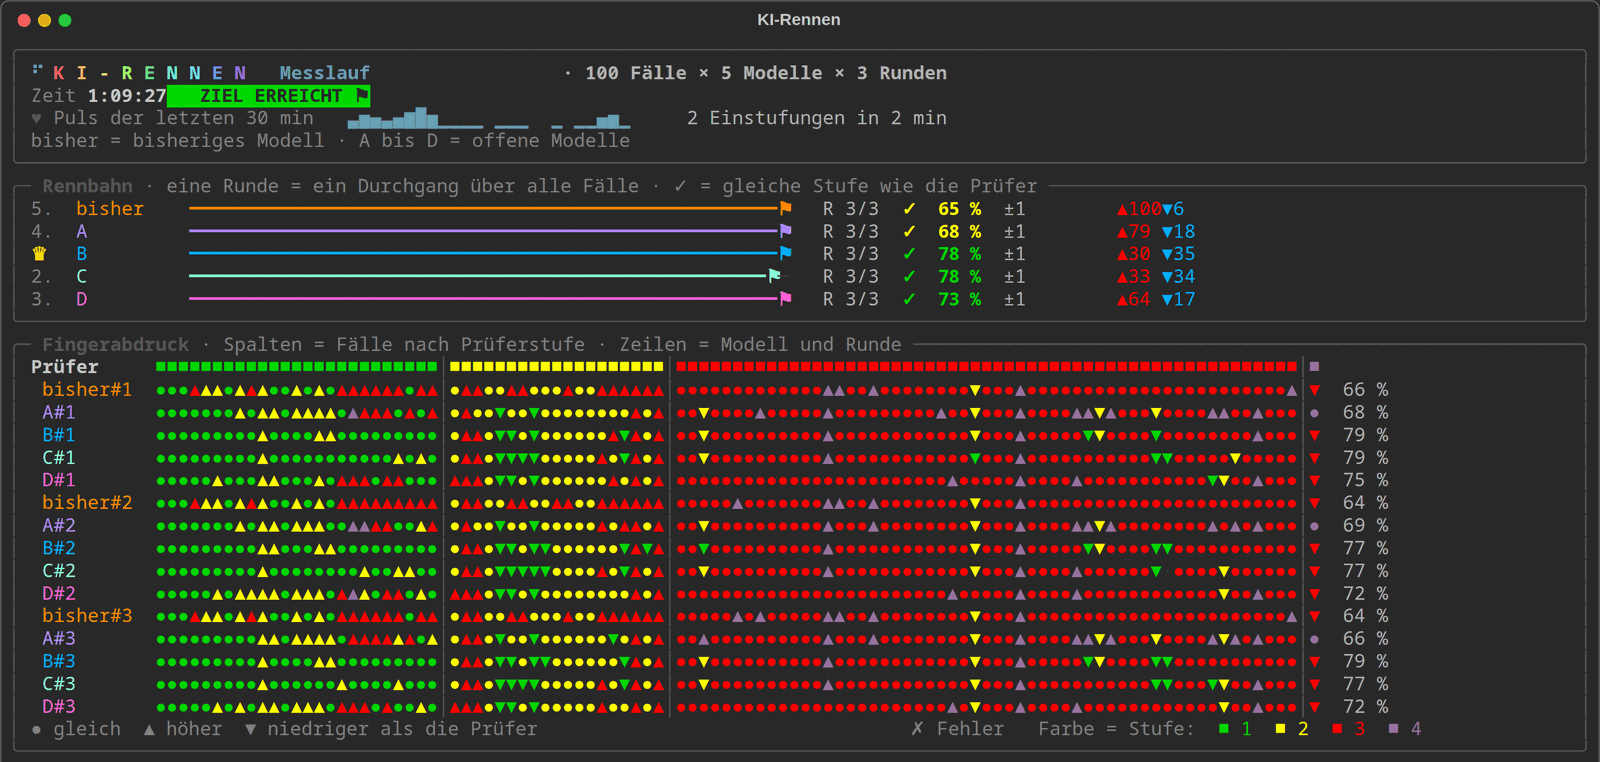
In Social Monitor, unserem Werkzeug zur Beobachtung von Online-Diskursen, erhält jeder erfasste Beitrag von einer KI je nach Thema eine passende Vor-Einstufung in unterschiedliche Stufen oder Kategorien. Als KI dient dafür bisher ein großes kommerzielles Sprachmodell, das sein Anbieter im Frühjahr 2027 abschalten wird. Das dann zur Verfügung stehende Nachfolgemodell stuft in unserem Test jedoch schlechter ein. Zudem blieb bei einem Kunden, der Social Monitor zur Beobachtung extremistischer Diskurse einsetzt, die Auswertung mit dem neueren Modell gerade dieses sensiblen Materials an den Sicherheitsfiltern des Anbieters hängen. Deshalb haben wir uns auf die Suche nach einer Alternative gemacht und erproben die Vor-Einstufung seit Anfang November an offenen Modellen, die wir dann selbst betreiben würden. Gemessen werden sie an eigenen, von Menschen geprüften Fällen, mit denen wir sie auch nachtrainieren. Grundlage der Tests ist die Vor-Einstufung für extremistische Diskurse, die vier Stufen kennt, von harmlos bis zur akuten Gefährdung. Auf der Seite zu meinen Fortbildungen über KI in sozialen Einrichtungen habe ich angekündigt, darüber zu berichten, sobald Ergebnisse vorliegen. Ein Teil davon liegt inzwischen vor. Der Rest folgt, wenn die laufenden Tests abgeschlossen sind.
Wer in den Sozialwissenschaften Diskurse untersucht, kann selten alles lesen, was zu einem Thema gesagt und gezeigt wird. Aus dieser Grundgesamtheit wird deshalb eine Stichprobe gezogen, die sich mit vertretbarem Aufwand auswerten lässt und das Ganze möglichst getreu abbilden soll. In extremistischen Online-Diskursen wächst die Grundgesamtheit allerdings ohne erkennbare Grenze. Jeden Tag kommen auf mehreren Plattformen und in mehreren Sprachen Videos, Predigten, Kommentare und Bilder hinzu - gerade auch aufgrund des verstärkten Einsatzes von KI für die Erstellung dieser Inhalte - , sodass der Anteil, den Menschen in ihrer Arbeitszeit sichten können, im Verhältnis zum Ganzen ständig kleiner wird. Je kleiner dieser Anteil ist, desto schwerer lässt sich sagen, ob er für das Ganze steht.
Darin liegt der eigentliche Grund, in dieser Arbeit KI einzusetzen. Sie soll die menschliche Entscheidung nicht ersetzen. Ihre Aufgabe ist es, eine verlässlich große Menge an Material überhaupt erst handhabbar zu machen und der Prüfung und Entscheidung durch Menschen zuzuführen. Auf dem Weg dorthin sind wir auf Herausforderungen gestoßen, die jeden betreffen dürften, der in Forschung, Prävention oder Extremismusbeobachtung mit Sprachmodellen arbeitet. Keine davon hat sich als unlösbar erwiesen. Ich beschreibe sie so weit, wie es ohne Einblick in die interne, technische Logik von Social Monitor möglich ist.1
Ein Modell, das die Arbeit verweigert
Kommerzielle Sprachmodelle sind darauf ausgelegt, Gewaltverherrlichung, Terrorpropaganda und Hetze nicht weiterzutragen. Ihre Anbieter setzen dafür Sicherheitsfilter ein, die eine Anfrage abweisen oder abbrechen, sobald sie solches Material erkennen. Für die meisten Anwendungen ist das richtig. In der Beobachtung extremistischer Diskurse wird es zum Hindernis, weil gerade dieses Material ausgewertet werden muss. Auch der Nachfolger des bisherigen Modells verweigerte in unserem Test bei extremistischem Material immer wieder die Arbeit, etwa die Übersetzung eines Beitrags oder dessen Einstufung, sodass ein Wechsel innerhalb desselben Anbieters das Problem nicht gelöst hätte. Hinzu kommt eine zweite Abhängigkeit. Wer seine Auswertung auf ein Modell stützt, das der Anbieter verändern oder abschalten kann, verliert mit ihm die Vergleichbarkeit seiner Ergebnisse über die Zeit. Für eine Beobachtung, die Entwicklungen über Monate und Jahre sichtbar machen soll, wiegt das schwer.
Ein offenes Modell, das wir selbst betreiben, würde beide Schwierigkeiten lösen. Welche Fassung im Einsatz ist, könnten wir dann selbst festlegen, sodass sie uns niemand abschalten oder unbemerkt verändern kann. Die Tests laufen in einem europäischen Rechenzentrum. Im Betrieb soll das Modell auf eigener Hardware laufen, womit das Material unser Haus nicht verlässt. Ob es mit schwierigem Material zurechtkommt, haben wir an 41 besonders problematischen Beiträgen geprüft, darunter Verherrlichung von Terror und Märtyrertum, Antisemitismus und Beiträge, deren Übersetzungen und Einstufung von dem neueren Modell verweigert wurde. Bei 117 Einstufungen und 28 Übersetzungen hat das offene Modell keine einzige verweigert. Auch die Beiträge, an denen das kommerzielle Modell gescheitert war, hat es vollständig übersetzt.
Gemessen an menschlichen Urteilen
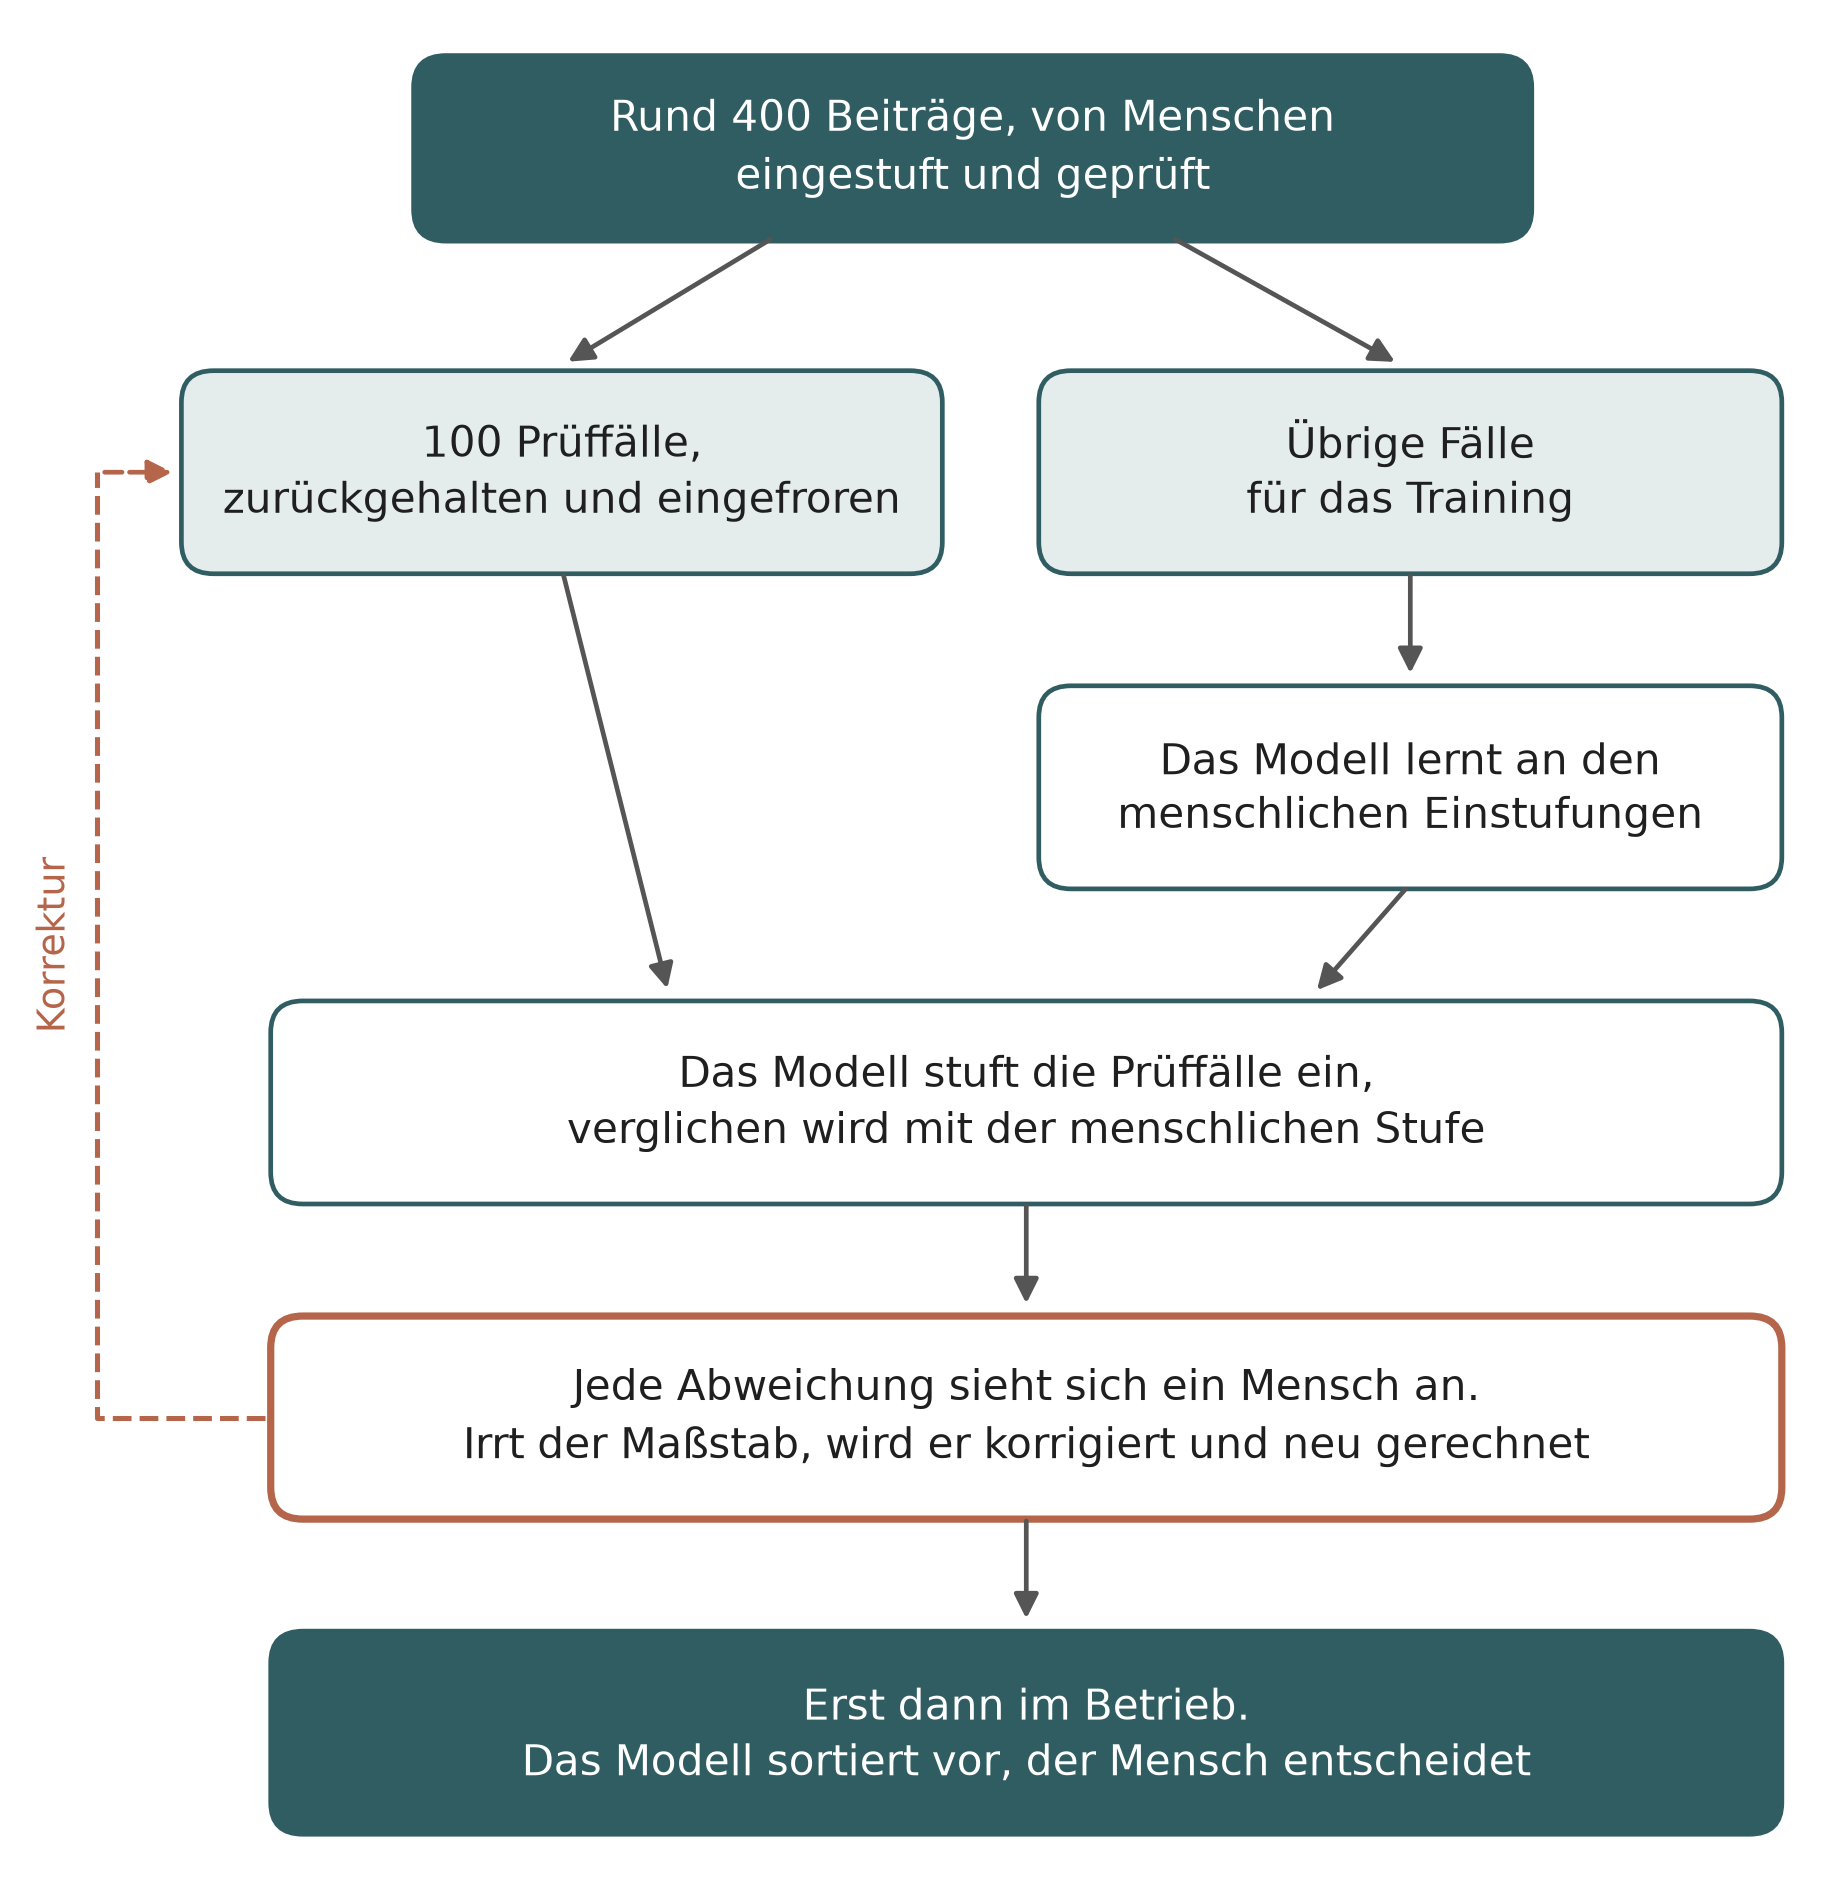
Ob ein Modell gut einstuft, lässt sich nur an einem Maßstab messen, der aus menschlichen Urteilen besteht. Für das Vorhaben standen rund 400 Beiträge zur Verfügung, die Menschen eingestuft und geprüft hatten. Hundert davon haben wir als Prüfmenge zurückgehalten und eingefroren, damit die Vergleichbarkeit gewahrt wird. Die übrigen kamen beim Training zum Einsatz.
Auch ein solcher Maßstab ist allerdings ein Urteil, das irren kann. Wir lassen die menschlichen Einstufungen deshalb zusätzlich von einer KI gegenlesen, die Zweifelsfälle markiert, weil sie den letzten Fall mit derselben Aufmerksamkeit liest wie den ersten. Über jeden markierten Fall entscheidet ein Mensch. Gemessen wird erst, wenn der Maßstab auf diese Weise geprüft ist. Für die Sozialwissenschaften halte ich das für eine der wichtigsten Erfahrungen dieser Wochen, denn die KI hilft hier, die Grundlage zu verbessern, an der sie selbst gemessen wird, während die Entscheidung beim Menschen bleibt.
Aneignen oder zitieren
Die schwierigste Unterscheidung ist zugleich eine, an der die Einstufung besonders oft hängt. Macht sich jemand ein Zitat zu eigen, oder gibt er es wieder, um ihm zu widersprechen? Kleine Modelle, wie sie auf einem gewöhnlichen Laptop laufen, scheitern daran meist. Größere Modelle unterscheiden besser, doch die oberste Stufe bleibt für alle schwer. In ihren Begründungen benennen die Modelle die entscheidenden Merkmale, etwa den Aufruf an Armeen, militärisch einzugreifen, ziehen daraus aber nicht den Schluss, den ein menschlicher Prüfer zieht.
In Social Monitor ist die Vor-Einstufung deshalb als Wegweiser angelegt. Sie zeigt, welche Beiträge ein Mensch zuerst ansehen sollte, während die Entscheidung über die schweren Fälle bei ihm bleibt.
Begründungen, die am Material bleiben
Eine Stufe allein hilft dem Menschen, der prüfen soll, wenig. Brauchbar wird sie mit einer Begründung, die benennt, was im Beitrag die Einstufung trägt, weil sich das in kurzer Zeit nachprüfen lässt. Sprachmodelle neigen allerdings dazu, mehr in einen Beitrag hineinzulesen, als dort steht. Sie erfinden etwa einen Bildinhalt oder machen aus der Angabe, jemand bewege sich „im Umfeld einer Organisation“, die Mitgliedschaft einer namentlich genannten Person. In der Beobachtung von Extremismus ist eine solche Zuschreibung kein kleiner Fehler, denn sie rechnet einen Menschen einer Organisation zu, der er womöglich nicht angehört.
Jede Begründung wird deshalb, bevor sie verwendet wird, daran geprüft, ob das, was sie anführt, im Material tatsächlich vorkommt. Was diese Prüfung nicht besteht, wird verworfen. Die Stufe selbst stammt im Training immer von einem Menschen, sodass das Modell an menschlichen Urteilen lernt. Diese Sorgfalt kostet Zeit. Sie ist aber die Voraussetzung dafür, dass ein Mensch einer Begründung so weit trauen kann, dass er an der richtigen Stelle nachsieht.
Deutsch mit arabischen Zitaten
Ein großer Teil des Materials ist gesprochen, in Videos, Predigten und Ansprachen. Dabei zeigte sich, dass manche Videos, die als arabischsprachig galten, tatsächlich deutsch gesprochen sind, von Menschen, für die Arabisch Erst- oder Gebetssprache ist, mit eingestreuten Koranversen und Prophetenworten. Für die Auswertung von Diskursen sind gerade diese Zitate wichtig, denn welcher Vers oder welches Prophetenwort angeführt wird, gehört oft zum Kern der Aussage.
Die Spracherkennung tut sich mit dieser Mischung schwer. Gängige Modelle schreiben die arabischen Zitate in lateinischer Umschrift, übersetzen sie oder lassen längere Stellen aus. Auch die naheliegende Idee, vorab die Sprache zu bestimmen und dann das passende Modell zu wählen, hilft wenig, weil ein solches Verfahren akzentgefärbtes Deutsch für Arabisch hält.
Wir bewahren den arabischen Wortlaut längerer Zitate deshalb als gekennzeichneten Zusatz zur deutschen Abschrift. Ob das trägt, zeigt ein Hörtest mit 24 Ausschnitten von 20 bis 30 Sekunden, die ich selbst angehört und mit der Abschrift verglichen habe. Von den Zusätzen zu längeren Zitaten war keiner falsch, die meisten stimmen vollständig. Wer Arabisch liest, hat das Zitat damit zum Prüfen vor sich und kann es einem Vers oder einem Prophetenwort zuordnen, bevor er entscheidet, ob er den Ton selbst anhört.
Die kurzen Formeln, wie Muslime sie im Deutschen selbstverständlich sprechen, stehen in der Abschrift dagegen in lateinischer Umschrift. Das halte ich für richtig, weil sie inzwischen zur deutschen Rede gehören, so wie ein Christ zwischendurch Halleluja sagt.
Eine maschinelle Abschrift ist allerdings kein feststehendes Dokument wie ein gedrucktes Protokoll. Eine Aussage, die belegt werden soll, prüft deshalb ein Mensch, der beide Sprachen versteht, am Ton selbst. Auch hier entscheidet die Maschine nichts. Sie sorgt dafür, dass das, worüber ein Mensch entscheiden muss, unterwegs nicht verloren geht.
Ein kleineres Modell, das mithält
Das offene Modell ist deutlich kleiner als das kommerzielle und hat schon ohne jedes Training mit ihm mitgehalten. Je nach Messung lag es gleichauf oder deutlich davor, zuletzt, gemessen in der Anwendung selbst, bei 75 gegenüber 55 von hundert menschlichen Einstufungen. Im Juni habe ich geschrieben, dass KI in der Sozialen Arbeit nicht glänzen, aber verantwortbar funktionieren muss. Für die Auswertung von Diskursen scheint das ebenso zu gelten.
Ein Modell, das schon untrainiert besser abschneidet als das bisherige, ist eine gute Ausgangslage. Mit Training soll es gezielt dort besser werden, wo die Einstufung am schwersten fällt. Was das Training hinzufügt, messen wir an einer größeren Prüfmenge. Unabhängig davon geht kein Modell in den Betrieb, bevor es an menschlichen Einstufungen gemessen ist und seine Abweichungen einzeln nachgeprüft sind.
Was daraus folgt
Die beschriebenen Herausforderungen stellen sich nicht nur bei extremistischen Inhalten. Sie betreffen jedes Vorhaben, das eine Grundgesamtheit dieser Größe mit KI auswerten will, in der Forschung ebenso wie in Prävention, Verwaltung und sozialen Einrichtungen. Lösbar wurden sie dort, wo ein menschliches Urteil den Maßstab bildet, an dem das Modell gemessen wird, und wo jede Abweichung wieder bei einem Menschen landet. Unter dieser Bedingung erweitert KI das, was Menschen prüfen können, ohne ihnen die Entscheidung abzunehmen.
Diese Erfahrungen fließen in Social Monitor ebenso ein wie in meine Fortbildungen über KI in sozialen Einrichtungen und in die Begleitung von Trägern, die den Einsatz von KI regeln wollen. Sobald die größere Prüfmenge ausgewertet ist, berichte ich über die Ergebnisse des Trainings.
Bildnachweis. Das Beitragsbild ist eine KI-generierte Illustration.
Engin Karahan
Ich berate, schule und begleite Organisationen, Behörden und Sicherheitsakteure mit über 20 Jahren Erfahrung in der migrantischen und muslimischen Verbandslandschaft Deutschlands. Mehr über mich
Sie möchten das Thema für Ihre Institution einordnen?
Schildern Sie kurz Ihr Anliegen. In einem vertraulichen Erstgespräch klären wir, was Sie brauchen.
Erstgespräch vereinbaren Beratungsangebot ansehenFußnoten
Alle Zahlen stammen aus der internen Dokumentation des Vorhabens vom 9. bis 16. November 2026. Die Modelle bleiben ungenannt, Beispiele aus dem Material erscheinen nur ohne Wortlaut und ohne Bezug auf Personen, Konten oder Projekte.↩︎